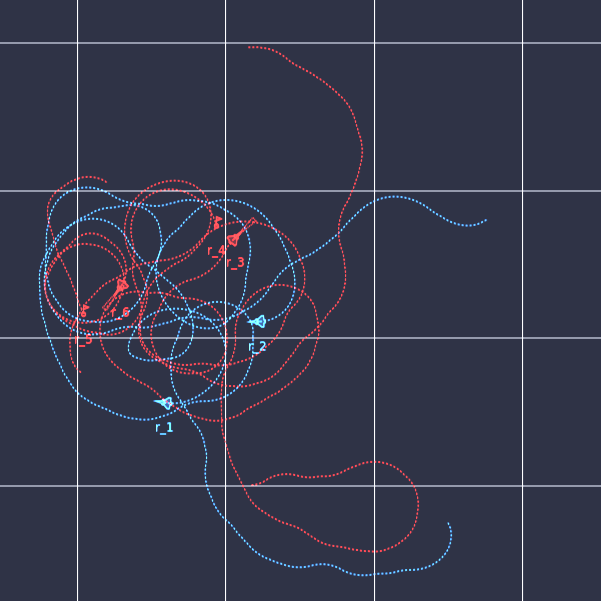
在真实空战中,飞行员需要在瞬息万变的环境中做出机动和战术决策,而我们希望让 AI 也能学会这些技能。通过强化学习,多架战斗机智能体可以自主判断何时攻击、何时撤退,并选择最优机动方式,实现“击杀最大化 + 生存最优”。
空中对抗的核心是智慧,决定胜败的往往是通过层次决策形成的精准机动,而非单纯的武力硬碰硬。
通过分层决策,高层负责战术指令(fight / escape / 选择目标),低层负责连续控制(航向、速度、武器发射)这样AI 不仅能做大局决策,还能执行精细动作。
1 项目目标
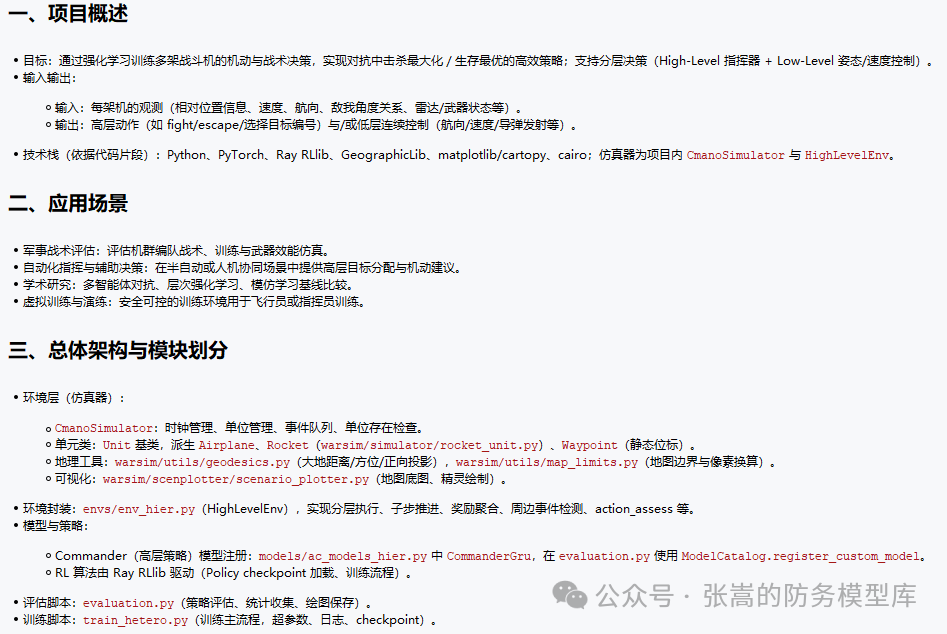
通过训练多架战斗机智能体,让它们在虚拟空战中自主做出决策。每架战机输入自身的观测信息(位置、速度、航向、敌我角度、雷达/武器状态等),输出高层动作(fight/escape/目标选择)或者低层连续控制(航向、速度、导弹发射)。通过这种方式,AI 能够同时掌握战术决策与精细机动。
2 系统架构
系统分为三大模块:
1. 环境层(仿真器):CmanoSimulator 提供时钟管理、单位管理、事件系统和地图绘制,HighLevelEnv 实现分层执行、奖励聚合和周边事件检测。
2. 模型与策略层:高层策略 CommanderGru 负责战术决策,低层控制飞行动作和武器使用。
3. 训练与评估层:使用 Ray RLlib 驱动强化学习算法(如 PPO/IMPALA/A2C),并通过 evaluation.py 评估策略效果和可视化训练结果。
3 分层强化学习设计
系统的高层负责战术级别的判断,低层则负责把战术意图转成可执行的机动动作。高层每发出一次抽象指令,低层会连续执行若干仿真子步,直到达到触发条件(距离接近、攻角变化、状态异常等)再返回高层做下一轮决策。
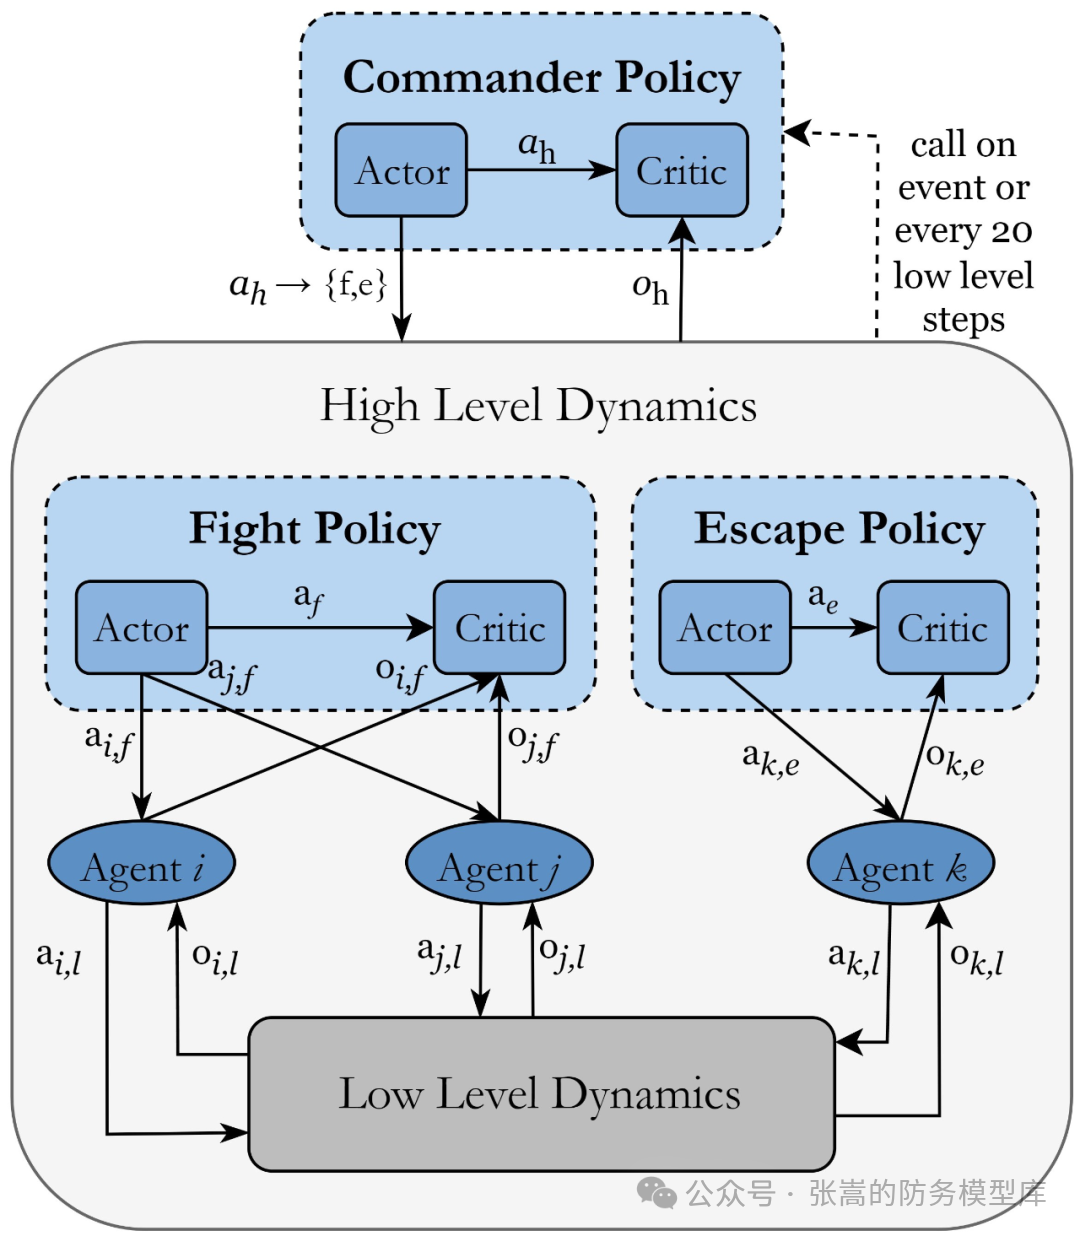
1. 高层(指挥官):做战术级决策,例如 fight/escape、选择攻击目标。奖励基于击杀、局部战术优势和逃脱成功等因素。
2. 低层(机动控制):执行航向、速度、武器发射等动作,通常遵循高层指令直到触发终止条件(如靠近敌人或达到子步上限)。
3. 多智能体协作:我方和敌方智能体共存,奖励可共享(glob_frac 控制共享比例),支持从自私到完全团队协作的训练策略。
4 仿真建模
虚拟空战环境包括:
1. 单位模型:飞机和导弹属性(位置、速度、航向、最大转角等)。
2. 事件系统:记录击杀、被击毁、导弹命中或失效事件,并用于奖励计算。
3. 地图与坐标:使用大地坐标和投影计算距离与方位,并可绘制雷达视野和飞行轨迹。
4. 子步循环:高层动作触发低层连续子步仿真,子步中持续计算奖励和检测临界事件。
5 奖励设计与训练技巧
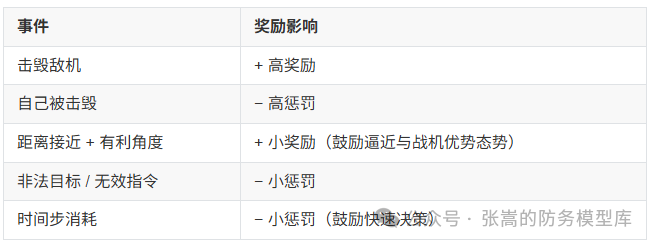
强化学习的核心是奖励。奖励设计得好,智能体就能迅速学到我们想要的战术逻辑;设计不好,智能体就会“乱飞”“乱打”。在空战中,我们主要围绕三件事给奖励:击杀、存活、占位优势。核心奖励机制包括:
1. 击杀奖励(主要正奖励)当我方击毁敌机,会给高额奖励,引导智能体更主动、更果断使用武器。
2. 被击落惩罚(主要负奖励)我方被击落会扣大量分,迫使智能体在对抗中学会“保命”。
3. 局部战术奖励(小额奖励)例如:接近有利角度(敌机落在我方前方 30° 锥内);成功拉开距离或脱离危险区;维持优势位置;这些奖励帮助智能体细化对机动细节的理解。
4. 时间惩罚(微小负奖励)每拖一秒就扣一点分,逼它学会“快准狠”,减少无意义的绕圈。
在训练过程中,我们还加入了多种“稳态技巧”,让智能体避免陷入局部最优:
1. 状态归一化:让不同尺度的输入(距离/角度/速度)保持在可控范围内。
2. 帧堆叠:给智能体历史信息,让它具备一定的“短时记忆”。
3. 对手策略随机化:敌方不是固定策略,避免“只会打这一种对手”。
4. 课程学习(Curriculum Learning):从简单场景学起,1v1 → 2v2 → 3v3,随着规模增大,战术复杂度自然提升,训练也更稳定。
6 训练与评估流程
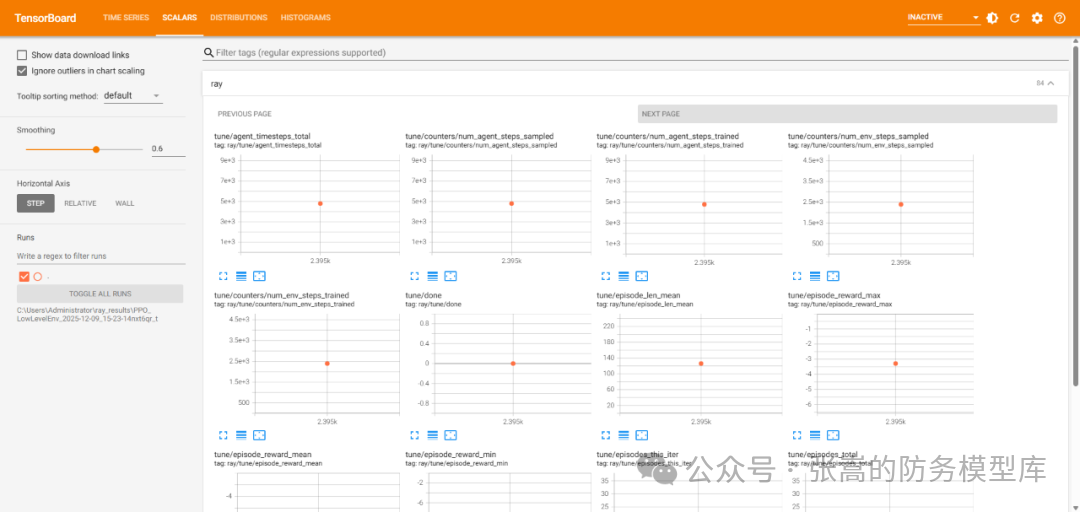
整个训练过程就是反复循环“跑仿真 → 拿奖励 → 更新策略”。我们使用 RLlib 这样的分布式框架,可以同时开多个环境并行跑,提高数据效率。
训练主要包含四步:
1. 环境配置与初始化:配置智能体数量、对手数量、动作空间、奖励开关(是否启用击杀奖励、角度奖励等),并加载地图数据与仿真器参数。
2. 注册策略模型并创建训练器:CommanderGru 作为高层模型接入 RLlib,训练器选择 PPO/IMPALA 等主流算法,设定学习率、批大小、gamma、clip 参数等核心超参。
3. 训练过程(rollout + 更新):多环境并行 rollout:每个智能体不断探索不同战术、累积奖励、策略梯度更新、定期保存 checkpoint(便于回滚与比较)
4. 评估策略(胜率 = 最硬指标):评估函数会在固定周期测一次模型实力,包括:胜率(agents_win / opps_win / draw)、击杀/被击率、平均回合奖励、动作分布(fight/escape 的比例)、目标选择规律(攻击 opp1/opp2/opp3 的倾向)、策略多样性(action entropy)
训练完成后,智能体可以自主选择目标、机动躲避、与队友协作,实现稳定、高效的战术决策。
7 总结
经过分层强化学习训练的多架战斗机,不仅能在仿真对抗中击杀最大化,也能尽量保证自身生存。通过奖励设计、课程学习、多智能体协作和随机化对手策略,它们学会了复杂的战术行为。
这套方法不仅可以用于军事战术评估,还可以扩展到无人机协作、空中指挥辅助、学术研究甚至虚拟训练环境。简单来说,就是让智能体“自己打仗、自己优化策略”,而我们只需要设计规则、搭建环境、提供奖励,让它们从零开始学会作战。
📩私信关键词 “强化学习” 到后台,获取完整项目代码!
5. 智能体推理工具!👉《GOAP如何成为战术决策核心》
7. 导弹碰撞模型设计!👉《武器模型设计(一)目标碰撞模型详解》
8. 命中率,不只是数字?👉《武器模型设计(二)命中率修正》