摘要:多智能体协同应用广泛,并被列为新一代人工智能(Artificial intelligence,AI)基础理论亟待突破的重要内容之一,对其开展研究具有鲜明的科学价值和工程意义。
随着人工智能技术的进步,传统的单一控制视角下的多智能体协同已无法满足执行大规模复杂任务的需求,融合博弈与控制的多智能体协同应运而生。在这一框架下,多智能体协同具有更高的灵活性、适应性和扩展性,为多智能体系统的发展带来更多可能性。鉴于此,首先从协同角度入手,回顾多智能体协同控制与估计领域的进展。
接着,围绕博弈与控制的融合,介绍博弈框架的基本概念,重点讨论在微分博弈下多智能体协同问题的建模与分析,并简要总结如何应用强化学习算法求解博弈均衡。选取多机器人导航和电动汽车充电调度这两个典型的多智能体协同场景,介绍博弈与控制融合的思想如何用于解决相关领域的难点问题。
最后,对博弈与控制融合框架下的多智能体协同进行总结和展望。

引言
多智能体协同是指具备一定计算、通信、感知、学习和执行能力的智能体,通过协作完成单一智能体无法胜任的大规模复杂任务[1]。多智能体协同是人工智能、自动化、通信和机器人等领域交叉融合的产物,也是多智能体系统领域研究的核心之一。此外,多智能体协同还被列为新一代人工智能亟待突破的基础理论瓶颈—自主协同与决策的主要内容之一,具有重要的科学研究价值。近年来,随着人工智能和机器人等技术的迅猛发展,多智能体系统协同理论研究也取得长足进步,并广泛应用于仓储物流、电网调度等民用领域,以及战场侦查、空中对抗等军事领域。
早期对于多智能体协同的研究主要从控制视角出发,旨在建立多智能体协同基础理论。沿着“一致性” (定义见第1节)这条主线,研究人员围绕个体动力学以及信息交互两个关键要素,深入探索多智能体系统一致性分析(积分器、高阶线性系统和Lipschitz非线性系统[2-7]的一致性分析),以及带约束的多智能体系统一致性控制(通信时滞、动态拓扑以及执行器饱和/失效下的一致性控制[8-15]),揭示了多智能体系统协同的内在机理和特性。
正如文献[16]指出,随着智能体变得越来越智能,从而可以完成更复杂任务,考虑更多的主动(Active) 而非仅被动(Passive)目标成为必然趋势。在实际场景中,多智能体之间固然需要协同以完成整体任务,每个智能体也会有自身独立的目标[17],例如每个智能体自然地期望以最小代价实现相互间协同。在这种情形下,可根据每个智能体内在需求构造特定的目标函数,以包含协作信息并反映智能体之间的关联或者制约,引导智能体在对目标函数优化时还能实现整体协同。
上述框架难以仅用多智能体协同控制相关概念来描述,但可以结合博弈理论框架进行建模和刻画[1,18-20],即每个智能体根据自身目标独立地做出决策,并在决策中考虑其他智能体可能采取的行动,所有智能体执行策略后最终能够实现相互间协同。由此可见,博弈与控制理论的融合具备刻画并实现多智能体复杂协同行为的能力,潜力巨大。
此外,通过交叉融合,既可以发挥博弈框架强大的问题建模能力以刻画更丰富的多智能体协同行为,也可以融合协同理论辅助突破博弈分析与求解面临的瓶颈问题,例如利用协同理论分析博弈均衡的可控性[21],或者求解博弈均衡[22]。近年来,在新一轮人工智能浪潮的推动下,研究人员将更多注意力放到挖掘和发挥多智能体的“智能”属性上,以便满足各种复杂场景下任务执行的需求,因此越来越多的工作将博弈与控制理论方法相融合,旨在突破多智能体优化决策/协同控制难题。
融合博弈与控制的多智能体系统研究已经取得初步进展,例如基于零和博弈的鲁棒控制问题、基于一般和博弈的最优控制问题以及基于团队博弈的协同控制问题研究[18-19]。特别地,目前融合博弈与控制的多智能体协同研究正在蓬勃开展,已经诞生不少研究成果,因而有必要对研究现状进行阶段性梳理。实际上,近年来已有综述开始关注在多智能体系统中博弈、控制与学习的交叉融合。
例如文献[19]简要介绍了如何利用博弈框架建模、分析分布式控制问题,而文献[20]则较为系统地回顾了演化矩阵博弈(Evolutionary matrix game)的分析与控制,但是对多智能体协同关注较少。文献[18]从博弈、控制与学习交叉的视角梳理多智能体系统的相关研究脉络,着眼于探索新的研究范式,虽然涉及基于博弈的多智能体最优协同控制,但是内容较为简略。
本文从交叉融合视角出发,首先回顾多智能体系统一致性分析和控制领域的主要研究框架和核心研究进展,揭示多智能体系统一致性的内在机理、概述一致性控制中不同约束的处理方法,进而探讨基于一致性的多智能体协同估计问题。在一致性分析与控制的基础上,进一步引入微分博弈框架建模多智能体系统协同优化控制问题,并结合最优控制和强化学习,阐述如何对其进行分析和求解。在应用方面,分别选取多移动机器人导航和电动汽车充电调度两个典型场景,介绍博弈与控制融合的思想如何用于解决相关领域的难点问题。本文的总体结构框架见图1。
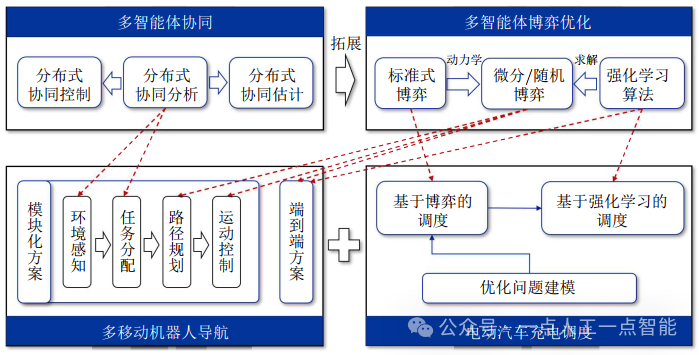
图1 本文总体结构

多智能体协同
多智能体通过协同可以完成编队、覆盖、蜂拥等基本控制任务,从而为更复杂任务的完成提供支撑。多智能体一致是协同的核心,编队、覆盖、蜂拥等控制任务均可以在一定程度上转化为多智能体一致性控制问题,例如基于状态一致性的偏置实现编队控制[23]。本节将视野聚焦到多智能体一致性展开叙述。下面首先介绍多智能体系统一致性的数学描述。
多智能体间的交互 1通常使用图论工具来描述。一个动态图G(t)由节点集N,边集 和边的权重
 刻画,其中每个节点对应一个智能体。如果在t时刻智能体i能够获得智能体j的信息,则称智能体j是智能体i在t时刻的邻居;此时存在一条从智能体j指向智能体i的边
 ,其权重值
 >0,否则
 =0。
考虑如下由N个同构的连续型智能体 1组成的系统:
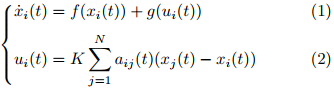
其中, 表示第i个智能体的状态(刻画智能体的位置、电量、速度等信息),
 表示输入,并且本节假定ui只能获取局部的信息。
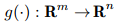 表示具有特定性质的函数,并视情况做出具体设定。对于多智能体系统(1),如果
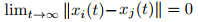 对任意i,j和任意初值xi(0)成立,那么称其实现了全局渐近一致。
对上述多智能体一致性问题开展研究通常需要考虑三个基本要素,分别是个体自身动力学(对应 、个体间交互(对应
 及其相关项)以及状态耦合(对应函数g(·)和矩阵K。在一致性分析中经常假定g(·)为输入ui的线性函数,并围绕上述三个基本要素,揭示它们对多智能体一致性的本质影响。而一致性控制则在上述分析的基础上,从实际场景出发对g(·)的结构或特性做出具体约束,并通过设计参数(例如反馈矩阵K)以实现多智能体渐近一致性。
1.1 动态拓扑下的分布式协同分析
本节围绕动态拓扑带来的挑战,介绍已有工作如何刻画时变通信拓扑、个体自身动力学、部分状态耦合等多重因素对多智能体一致性的影响,分别讨论不同阶次的动力学,并沿着通信拓扑条件如何放松这一主线介绍相关进展。
1.1.1 积分器型智能体: f(·)=0且g(·)=K=I
针对积分器型多智能体系统,研究人员已揭示动态通信拓扑下实现一致性的各种充分必要条件[2-4,24-25]。值得关注的是一类联合 –连通性条件。这一条件要求给定
 ,对任意时间t满足如下条件的边(i,j),
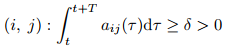
构成的图是连通的。文献[24]揭示了联合 –连通性条件是无向动态通信拓扑下积分器型多智能体系统以指数速率实现渐近一致的充要条件。注意,上述联合
 –连通性条件只要求
 是可积函数,并未对
 施加额外要求,例如允许
 分段固定但是不要求有正的驻留时间下界,因此该条件要求宽松、适用范围广。此外,以指数速率实现一致性也保证了多智能体系统具有一定抗干扰和不确定性的能力。
1.1.2 高阶多智能体: 具有特定结构的g(·)或aij(t)
近十年来研究人员一直在探索动态通信拓扑下具有高阶个体动力学的多智能体系统一致性问题,其中一条重要主线致力于探索实现一致性的最弱通信拓扑条件。现有工作通常对通信拓扑[7,12,26-28]或系统参数(包括系统自身动力学和耦合函数g(·)[29-35]施加严格的条件。一方面,研究人员要求通信拓扑以较高的频率保持足够的连通性(Frequently connected)或通信拓扑的时间平均(Averaged topology)满足特定连通性条件,进而有利于开展多智能体系统的一致性分析[26-27]。例如,文献[7]假设分段连续通信拓扑的非零权重有一致的下界(Uniformly bounded),即通信拓扑的权重可以发生变化,但通信拓扑的连通性结构需要保持不变。
另一方面,研究人员还会假设耦合矩阵(对应线性的g(·))是行满秩的[29]或多智能体系统自身动力学(对应)具有非发散(Non-expansive)的性质,并以此为基础开展一致性分析。例如,Meng等[34]研究了具有满秩输入矩阵的非发散时变有限维非线性多智能体系统的一致性问题。此外,Lu等[31]、Meng等[32]、Abdessameud[35]以及 Liu等[33]考虑了异构多智能体系统的一致性问题。解决这类问题的主要思路在于借助内模原理,通过设计全状态耦合动态控制器(Dynamic controller)或参考信号(Reference signal),将带有高阶动力学的多智能体系统一致性问题转化为积分器型多智能体系统的一致问题[31-32,35],从而简化分析。文献[7,12,26-35]中的工作尽管已取得一定的研究进展,但仍面临一些问题。例如假定输入矩阵全状态耦合有助于放宽对通信拓扑连通性的要求,使一致性分析变得更易处理,但也限制了相关方法的适用范围。
1.1.3 高阶多智能体: 一般形式g(·)和aij(t)
如果高阶多智能体的耦合矩阵(对应线性$ g(\cdot) $)非行满秩,同时仅要求弱连通性条件,大多数多智能体系统一致性的研究都是基于无向通信拓扑展开的[36-39]。在Su等[36]的工作中,考虑了具有非行满秩输入矩阵的边缘稳定(Marginally stable) 2线性系统。这些线性系统通过分段固定的通信拓扑进行交互,且具有正的驻留时间(Dwell time)。文献[36]证明,通过合理的反馈矩阵设计,只要通信拓扑满足一致连通性(Uniformly connected)条件(联合–连通性的特殊情况)并且个体动力学系统可观(Observable),就能实现多智能体系统的渐近一致[36]。
文献[38-39]研究了分段固定通信拓扑或连续时变通信拓扑(即边的权重是时间的连续函数)下中立型稳定(Neutrally stable) 2 线性多智能体系统的一致性问题,分别发展了基于子空间分解[38]和一致完全可观(Uniform complete observability)的多智能体系统一致性分析方法[39]。上述方法的优势在于去掉了“正的驻留时间”这一条件,并给出实现一致性的充分必要条件[38-39]。
文献[37]放宽了对系统矩阵的约束,使得线性多智能体系统只需满足可控性要求,允许f(·)=A具有不稳定的特征值,但是仍然假设分段固定的通信拓扑具有正的驻留时间。文献[37]证明,如果Lyapunov指数(取决于系统动力学参数)小于同步性指数(取决于通信拓扑联合连通特性),就可以实现多智能体系统渐进一致[37]。
最近,文献[40]在Wang等[37]研究的基础上,提出一类图Laplacian矩阵函数的预紧性条件,大大放松了对通信拓扑的要求,并证明了在上述条件下通信拓扑联合−连通与个体动力学的可控性是多智能体系统以指数速率实现一致性的充分必要条件。上述结论在理论上证明了在一定条件下,联合
−连通性对于高阶多智能体系统以指数速率实现一致性仍然必要,是对积分器型多智能体系统下结论的推广。
1.2 实际约束下的分布式协同控制
本节主要围绕多智能体系统在实际约束下的一致性控制展开介绍。所考虑的实际约束包括: 执行器约束、通信约束以及交互约束,分别对应执行器饱和/失效下的协同控制、基于事件触发的协同控制以及竞合共存下的协同控制。上述约束均可以反映在函数g(·)或通信拓扑权重aij(t)的结构/特性上。一致性控制需要对系统中的相关参数进行设计(例如反馈矩阵K),并结合一致性分析的方法/结论,刻画一致性控制的稳定性、鲁棒性等。
1.2.1 执行器饱和约束下的协同
在实际控制系统中,所有控制驱动装置都服从饱和约束,即力、电压、流量等实际物理输入量在控制理论和技术的应用中最终都是有限的[41]。
本部分主要考虑具有有界输入下渐近零可控性质 3的线性系统,其在执行器饱和下的一致性控制研究主要有两个框架: 1)半全局一致性控制;2)全局一致性控制。
半全局一致性控制指的是给定以及
,在ui(t)的驱动下,有
对任意i,j成立。低增益反馈技术广泛用于渐近零可控线性系统在输入有界下的半全局一致性控制[8,42],其背后的原理在于,通过将反馈增益调节得足够低,只要初始状态在给定的集合内,系统将受到输入的线性作用,从而满足执行器饱和约束。利用低增益反馈技术,已有文献相继深入研究了固定拓扑[9]和切换拓扑[43]下带执行器饱和约束的一致性控制问题。
全局一致性控制指的是对任意,在ui(t)的驱动下,有
对任意i,j成立。一方面,研究表明,在无执行器饱和约束下设计的线性控制器可以实现带执行器饱和约束下的一致性控制[44-45];另一方面,具有特定形式和性质的非线性控制器也被证明可以实现带执行器饱和约束下的一致性控制[46-47]。例如,文献[46]利用饱和函数tanh(·)设计控制器,而文献[47]则借助
函数设计基于多跳中继机制的控制器,其中
: R→R定义为
表示符号函数。
1.2.2 执行器失效下的协同
由于老化或损坏,系统执行器、传感器或其他部件不可避免地会出现失效[48]。而对于多智能体系统,执行器、传感器或其他部件的失效问题由于系统规模和复杂度的提高变得更加严峻[49]。因此,在执行器失效时,如何有效识别并应对非常关键,这就要求开展故障识别与隔离(Fault detection and isolation,FDI)以及容错控制(Fault-tolerant control,FTC)研究。
FDI的作用是检测并隔离故障,减小故障对系统的影响或为故障处理作准备。针对FDI的研究主要有两种框架: 集中式与分布式。集中式FDI需要选取一个中心节点部署失效检测算法,并搜集系统的所有信息以执行该算法;与此不同,分布式FDI可以在每一个智能体单独部署,并仅利用局部信息开展失效检测,因此通信负担小、可扩展性好[10]。已有研究围绕分布式FDI,针对执行器、传感器、通信等故障开展了较为系统的研究[10,49−51],其中的核心方法之一是利用残差信号对故障进行检测与隔离[51]。
FTC的作用是对控制系统进行设计以应对潜在的故障,从而提高系统可靠性。现有针对多智能体系统容错控制的研究大多聚焦执行器故障[52-53],并可粗略地分为两大类: 被动容错控制以及主动容错控制。在被动容错控制中,控制器参数根据预期的故障类型预先设计,以提高特定情形下的系统鲁棒性能[52],因此这类方法无需系统的实时故障信息;与被动容错不同,主动容错控制则自动地检测和识别故障模块,并据此重新配置系统参数以应对故障[53]。
1.2.3 基于事件触发的协同
为降低数据传输和控制器更新频次,节约通信和计算资源,文献[11]将事件触发控制框架[54]应用到多智能体协同中,由此引发了大量基于事件触发的多智能体一致性控制研究[55-56]。
在事件触发机制中,当测量误差超出设定阈值时相应事件触发,从而开始数据传输和控制器更新,因此测量误差和阈值的设计至关重要。一般来说,测量误差的设计有三种不同形式,包括: 1)一般形式[11];2)组合形式[57];3)基于模型的形式[58]。阈值的设计则可划分为: 1)状态无关形式[59];2)状态相关形式[11];3)混合形式[60]。
1.2.3.1 测量误差设计
假定第i个智能体的触发时间序列是,
,那么一般形式的测量误差定义为[11]:
。采用上述测量误差,在任意智能体上定义的事件触发时,所有智能体都要进行信息传输和控制器更新,这将导致更新频率过高的问题。
为解决上述问题,文献[57]提出了组合形式的测量,并由此定义了组合形式的测量误差:
。在这一框架中,任意智能体一旦检测到事件触发,只需收集其邻居节点的信息,并更新自己的控制器,大大降低了控制器更新频率。这一框架的缺点在于,一旦通信拓扑是有向的,上述邻居节点不知道何时发送信息,或者智能体需要向其邻居节点发送信息传输请求,从而增加通信代价[61]。
上述两类测量误差(一般形式和组合形式)仅适用于积分器型多智能体系统[11,57]。对于一般线性多智能体系统,通常需要考虑到系统动力学特性的影响。文献[58]提出基于模型的测量误差:。式中的矩阵指数
用于估计当前时刻系统的状态,以避免
增长过快。
1.2.3.2 触发阈值设计
状态无关形式的阈值通常设计为带有非负下界的递减函数形式[59]。这样做的好处是可以轻易排除掉Zeno现象,同时在判断触发与否时无需邻居节点的信息。状态无关形式的阈值设计能有效降低通信负担,但在判断触发时没有利用系统相关信息,潜在造成了系统性能的改变,例如系统收敛速率可能取决于阈值本身[57]。
状态相关形式阈值设计缺乏统一的形式,按其特性可大致分为两种,即连续形式和分段固定形式。例如,连续形式阈值可设计成[57],其中,
>0是与个体自身动力学、通信拓扑相关的参数,sqrt(·)表示平方根函数。显然,上述连续形式的阈值需要连续监测邻居状态。为解决这一问题,还可以采用离散形式的阈值,将连续的状态量替换为采样状态[62]。
混合形式的阈值则将连续形式和分段固定形式的阈值相结合[62],在有效利用系统信息的同时寻求避免Zeno现象,但是也带来分析和设计上的挑战。
1.2.4 竞合共存下的协同
社会网络可以看作一个典型的多智能体系统。在社会网络中,个体之间既可以合作,也可以竞争[63]。这导致对立子群的出现,产生了二部一致概念,即网络分为两个子群,每个子群内部达到一致,而子群之间状态则相反。文献[64]展示了如何根据个体间合作/竞争、喜好/厌恶等关系构造边权重带符号的图(简称符号图),以刻画个体间不同性质的关系。
沿着上述符号图构建的思路出发,研究人员根据Laplacian势能函数的梯度构造了多智能体系统的分布式控制策略以实现二部一致:。研究发现,二部一致的必要条件是符号图具有结构平衡的特性(Structurally balanced)[63]。在这一条件下,可以采用规范变换(Gauge transformation)[63]将二部一致问题转化为一致性问题,并探索固定[9]或时变[65]通信拓扑下的二部一致问题。
除了二部一致,在协作、竞争共存的网络中,可能存在两个以上的智能体子群,其中子群内部是合作的关系,而子群之间合作/竞争并存。针对这类情形的研究产生了分群一致或聚类一致的概念[66-70]。
现有工作主要分为两类: 1)从探索拓扑结构特性入手,揭示拓扑结构、耦合强度等因素对分群一致的作用[66-67];2)设计外部输入信号引导子群的演化,进而刻画聚类一致的收敛性质[70]。更详细内容可参考文献[12]。
1.3 基于模型的分布式协同估计
多智能体协同状态估计是指由具备检测、通信以及计算功能的智能体利用检测信息和局部信息交互实现对动态目标状态的估计。本节主要关注基于模型的协同状态估计问题,对不同类型的分布式状态估计方法展开介绍,这些方法的设计均基于式(2)中给出的协同控制方法,利用其实现分布式的计算和信息融合。
在基于模型的协同状态估计问题中,模型是指目标状态演化模型
和智能体检测模型
其中,k表示智能体的采样时刻,x为目标状态,u为控制输入,yi为智能体i的检测值,v和是过程和检测噪声。分布式协同状态估计问题中的一个基本要素是通信拓扑,它反映了不同智能体之间的信息交互关系,一般会被建模成图的形式
,这里
表示随时间变化的动态拓扑图,静态拓扑图可以认为是各时刻拓扑均相同的动态拓扑图。
智能体通过通信拓扑向邻居传输本地检测信息或利用检测信息计算出的本地状态估计,将本地检测或估计信息与获取到的其他个体信息相融合,获得更加准确的目标状态估计。因此解决多智能体分布式协同状态估计问题的关键在于设计出有效的检测信息处理方法以及不同智能体间的信息交互和融合方法。基于此,研究人员从信息处理及信息融合角度出发设计了一系列多智能体分布式状态估计方法[71-77],这些方法从结构出发可以划分为Kalman滤波类方法[71-74]和一致–革新类估计方法[75-77]。
1.3.1 Kalman滤波类的分布式状态估计算法
自1960年Kalman[78]在具有里程碑意义的现代滤波理论中提出Kalman滤波后,随着研究的不断发展和深入,形成了包括扩展Kalman滤波[79]、无迹Kalman滤波[80]、中心差分Kalman滤波[81]、容积Kalman滤波[82]等在内的一系列估计方法,统称为Kalman滤波类方法,这类方法均包含基于目标状态模型的预测和基于检测信息的更新两个环节。基于Kalman滤波的分布式状态估计方法就是以Kalman滤波类方法为基础,结合多智能体一致性算法,使各智能体在每一次估计迭代过程中都能通过实时计算当前状态估计和相应协方差估计的局部平均值修正估计结果。
文献[71-72]将经典Kalman滤波和扩展Kalman滤波的信息形式与一致性算法进行结合,在每一次完成估计值的预测后,各智能体会利用通过局部信息交互获得的邻居智能体先验信息对和检测更新信息分别计算二者的局部平均,并在此基础上计算后验估计。这两种方法能够在通信拓扑强连通的场景中分别实现对线性和非线性目标状态的分布式估计。
文献[73]设计了基于一致的信息分组融合机制,并将其与扩展Kalman滤波的信息形式结合,在各组智能体的动态通信拓扑分别强连通时能够实现对非线性演化的耦合多目标状态的分布式估计。文献[74]利用一致算法融合检测信息、估计值及相应协方差,在容积Kalman滤波的基础上提出基于混合一致的分布式滤波方法,实现了高维分布式状态估计。
上述分布式状态估计方法均针对较理想的估计场景,智能体间的通信、智能体自身的信息采集等均不受限制。但是在实际应用场景中总会面对各种局限性和挑战。这些局限性和挑战针对的对象有所不同,可以根据其作用对象将协同估计问题分为有限通信下的协同估计[83-84]、不确定性目标的协同估计[85-86]、恶意攻击下的协同估计[87-88]等类型。
文献[83]基于一种涵盖有限带宽、可变延迟和丢包等网络现象的通用通信约束模型,设计了一种基于Kalman滤波递归分布式融合估计器,解决了一类网络物理系统的分布式协方差交集融合估计问题。文献[84]针对时变线性系统设计了一种基于事件触发的分布式状态估计方法,每个智能体在事件触发机制下选择性地将本地信息传递给相邻节点,以减少通信带宽需求。
面对目标状态存在不确定性的场景,文献[85]基于带有非线性不确定函数的扩展状态模型设计了基于扩展Kalman滤波的分布式预测器;文献[86]遵循一阶广义伪贝叶斯和交互多模型方法将分布式混合信息融合算法与扩展Kalman滤波相结合,解决了目标过程模型对任何智能体都不确定的情况下的分布式状态估计问题。多智能体系统作为一种典型信息物理系统,极易受到外部恶意攻击。
面对分布式状态估计过程中最常见的、以改变智能体检测信息为攻击方式的欺骗攻击,文献[87]针对时变线性目标提出一种快速弹性分布式状态估计器,无论攻击的强度和受损智能体的数量如何,都会产生有界状态估计误差;文献[88]针对非线性目标,设计了基于不变扩展Kalman滤波的弹性分布式状态估计方法,在连通的通信拓扑下能够实现欺骗攻击下的目标状态估计。
1.3.2 一致–革新类分布式状态估计算法
基于Kalman滤波的分布式状态估计方法均继承了经典Kalman滤波方法的特点——只能处理高斯噪声下的状态估计问题。而一致–革新类分布式状态估计方法能够克服这一局限性,在一般有界噪声下实现对目标状态的估计。此类方法中,分布式估计器的一般形式为
式中,是指k时刻智能体i所有邻居智能体的集合。等号右侧的第2项为处理检测信息的革新项,该项的作用是利用检测信息对状态估计进行修正;第3项为基于一致性算法设计的进行分布式信息融合的一致项,在该项的作用下所有智能体对目标状态的估计将达到一致。针对不同的场景,设计合适的函数g(·)和系数矩阵
可以实现对相应目标状态的分布式估计。
文献[89]提出一种用于电力系统广域监测的一致–更新类分布式状态估计算法,通过与指定的相邻控制区域进行信息交换,各个控制区域可以在通信拓扑连通的情况下实现对整个电力系统状态的无偏估计。文献[75]通过设计一致–革新类分布式状态估计器,实现了对移动机器人和地标的位置估计。文献[77]通过引入一组势函数设计了一种新颖的一致–革新类估计方法,使得可以进行能量收集的传感器网络能在间歇性通信下实现状态估计目标。
在非高斯的有界噪声下同样需要解决第1.3.1节指出的实际状态估计过程中需面临的各种局限性和挑战。针对通信条件的局限性,文献[76]设计的一致–革新类估计方法实现了无线衰落信道下随机哈密顿系统的分布式状态估计;文献[90]提出的基于事件触发的分布式一致–革新类估计方法通过构造数据调度器在降低通信损耗的同时保证了估计的准确性。
文献[91]针对高斯噪声、系统不确定性和非线性影响下的目标状态,对不确定性和非线性进行统一建模,设计了用于处理系统动力学和约束的估计器。面对恶意欺骗攻击,文献[92]针对线性目标状态设计了一种动态目标调节增益估计器,通过设计一致项的调节增益矩阵和更新项的自适应增益实现欺骗攻击下的分布式估计;文献[93]分析了一致–革新类分布式状态估计算法在联合欺骗攻击下的脆弱性,给出了部分或全部检测受到攻击时的算法性能被破坏且攻击无法被检测到的充分必要条件。
多智能体博弈优化
本节将在多智能体系统中进一步引入效用函数(Utility function),以刻画智能体本身的主动目标(Active objects),从而构建基于博弈的多智能体优化控制/决策框架,拓展多智能体系统适用场景和任务。特别地,在微分博弈框架中(见第2.2节),当上述主动目标置为常数时,这一优化/决策框架可退化为第1节的多智能体协同控制问题,因此第1节的研究对象可看成本节的特例。
本节的总体结构如图2所示。
第2.1节首先给出标准形式的多智能体博弈优化框架,接着介绍如何融合一致性控制等理论方法开展Nash均衡的分布式搜索,以及不同结构下的多智能体博弈问题;
第2.2节在博弈框架下重新表述多智能体协同控制问题,给出微分博弈框架的定义,介绍基于最优控制的多智能体微分博弈问题的基本形式和扩展形式,进一步在上述基础上介绍了多智能体图博弈,将一致性问题放到微分博弈框架下考虑,给出基于自适应动态规划(Adaptive dynamic programming,ADP)的均衡策略分析与计算方法;
第2.3节则针对博弈参与者具有状态概率转移的动态博弈过程,介绍多智能体随机博弈的基本形式和特殊形式随机博弈均衡解的计算方法,并探讨不同算法结构下的多智能体强化学习算法。
图2 第2节总体结构
2.1 标准式博弈与分布式Nash均衡搜索
在多智能体博弈问题中,每个智能体具有不同的优化目标,主要关注智能体如何依赖自身信息以及与邻居智能体的信息交互优化自身目标函数。
博弈模型一般包括参与者(即智能体)、策略集和效用函数三个要素。一个标准式博弈问题可描述为
其中,xi表示智能体i的策略,x-i表示除智能体i以外其他所有智能体的策略组合。为求解该博弈问题,期望寻找一个Nash均衡策略组合满足
式(4)表明,在Nash均衡策略下,任何智能体单方面改变自己的策略都不会使自身效用函数变小。当考虑带有耦合约束的多智能体博弈问题[94],即智能体i的策略集与其他智能体的策略x-i有关,则称满足式(4)的策略组合为广义Nash均衡(Generalized Nash equilibrium)策略。
2.1.1 分布式Nash均衡搜索算法的主要思想
Nash均衡策略的存在性和唯一性与伪梯度向量的单调性密切相关。一般地,当伪梯度向量满足某些单调性条件时,可保证Nash均衡的存在性和唯一性,相应的多智能体博弈问题也称为单调博弈(Monotone games)。尽管每个智能体的效用函数受到其他所有智能体策略的影响,但由于通信能力和通信成本受限,智能体一般只能与有限数量的其他个体通信。因此,相关研究工作用通信拓扑描述智能体之间的局部信息交流关系,基于一致性控制的思想提出了多种分布式Nash均衡搜索算法。相关算法的主要思想是为每个智能体设计一个关于所有智能体联合行动情况的局部估计,使用某种一致性协议更新其估计,并根据所得估计来更新动作。
文献[95]基于一致性思想提出基于节点和基于边的完全分布式Nash均衡搜索算法,证明了当通信拓扑为无向连通图时Nash均衡具有全局渐近稳定性,并将基于边的算法扩展到切换无向连通图的情况。文献[96-98]则考虑不同的通信拓扑切换形式,提出有效的分布式Nash均衡搜索算法,并讨论其收敛至Nash均衡或其邻域内的条件。
除一致性控制思想以外,研究学者还结合控制理论中的分析与综合技术,如无源理论、小增益理论、输出调节、非光滑动力学等,提出一系列新颖且有效的分布式Nash均衡搜索算法。如,文献[99]基于对无向图上多智能体协调问题的重述推导了新的动力学,提出基于增量无源特性的分布式Nash均衡搜索算法,并证明了其在任意连通图下的收敛性。文献[100]提出基于输出调节理论的分布式Nash均衡搜索算法,并通过输入–状态稳定性理论证明了算法收敛性。
2.1.2 不同结构下的多智能体博弈问题
在前述标准式博弈问题的基础上,相关研究学者结合实际应用背景设置不同形式的效用函数,探索了多种博弈结构下的多智能体博弈问题。文献[101-102]研究了两个智能体零和博弈(Zero-sum games)问题,其中两个智能体的收入或损失之和总为零或一个常数,即一个智能体效用函数的增加必然导致另一智能体效用函数的降低。因此,零和博弈的效用函数通常表示为,其中智能体1的策略x1期望最小化效用函数J,而智能体2的策略x2则期望最大化该效用函数。当效用函数满足某些凹凸性条件时,零和博弈的Nash均衡,也称鞍点均衡,满足
,
,
。
相关文献基于凹凸函数性质和鞍点性质进行探索,提出了一系列零和博弈Nash均衡搜索算法。此外,考虑到在一些实际问题中,智能体之间通过它们的聚合行为而非局部决策进行交互,每个智能体i的效用函数可以写成,其中l(x)表示所有智能体策略x的聚合行为。这种具有特殊效用函数结构的博弈称为聚合博弈(Aggregative games)[103],其广泛应用于电力市场、交通网络、意见网络、编队控制等领域中。针对这种特殊的效用函数结构,相关文献进一步研究了聚合博弈Nash均衡的定义、存在性、唯一性和分布式搜索方法等问题[104-106]。
当智能体数量非常庞大时,聚合博弈进一步演变为平均场博弈(Mean-field games)[107-108]。势博弈(Potential games)也是一种重要的多智能体非合作博弈,其要求所有智能体的效用函数满足某种全局特性。具体地,当存在势函数$ P $使得对于每个智能体i和策略集都满足
,
,那么将相应的博弈模型称为势博弈。基于效用函数特性,研究学者们提出了有效的势博弈Nash均衡计算方法[109],并在拥塞控制、分布式优化等多智能体决策问题中广泛应用[110-111]。
在前述博弈问题中,每个智能体作为利己个体优化自身目标函数,因此智能体之间在某些约束下相互制约,形成竞争关系。与此不同,多集群博弈(Multi-cluster games/multi-coalition games)考虑智能体之间同时存在竞争与合作,其中集群内部的智能体之间为合作关系,而集群之间为竞争关系。多集群博弈在一个统一框架下描述了分布式优化和非合作博弈问题。具体地,当只有一个集群时,多集群博弈问题退化为分布式优化,而当每个集群内只包含一个智能体时,该问题则退化为标准式博弈。相关的分布式Nash均衡搜索算法见文献[112-113]。
2.2 微分博弈与基于ADP的均衡策略计算
美国国家工程院院士、国际动态博弈论学会创始主席Bašar等[114]在其著作中系统地介绍了动态非合作博弈理论(Dynamic noncooperative game theory),其本质是将单智能体最优控制问题推广到多智能体系统中,为刻画智能体间的策略交互提供了一种有效框架。与第2.1节中介绍的多智能体博弈不同,这里涉及一个在连续时间内演化的动态决策过程,即参与者的博弈状态按照某一微分方程演化,因此也称为微分博弈(Differential game)。
2.2.1 微分博弈
一般地,多智能体微分博弈问题可描述为
其中,表示刻画动态决策过程的博弈状态;
表示智能体i的控制输入(控制策略);
=
表示除智能体i以外其他所有智能体控制输入的集合;f表示博弈状态x的动力学方程;Ji表示参与者i,i=1,…,N的累积性能指标;ri表示智能体i的立即成本,其一般设置为关于x,ui,u-i的二次型函数。上述多智能体微分博弈问题是由多输入系统最优控制演变而来,其中每个智能体通过各自的控制输入ui影响共同的博弈状态x。
参与者i的Nash均衡策略满足
其中,表示智能体i的最优值函数,
表示
关于x的梯度,Hamiltonian函数
定义为
由于均衡策略(5)依赖于最优值函数,且
的计算需要使用
和
,故无法直接显式计算均衡策略
。一般可通过求解如下耦合Hamilton-Jacobian-Bellman (HJB)方程来同时计算每个智能体的均衡策略:
在前述框架下,文献[115]将动态系统的控制输入和外界干扰考虑为两个具有竞争关系的博弈参与者,基于零和Nash博弈研究了动态系统$ H_{\infty} $控制问题。文献[116-117]针对具有多个控制输入的动态系统,研究了多智能体非零和Nash博弈问题。
考虑到智能体之间的地位和角色可能不同,其可用于决策的信息并非对称,文献[118-120]研究了多智能体Stackelberg博弈问题,将博弈参与者分为领导者和跟随者,其中跟随者总是根据观察到的领导者策略做出最优响应,而领导者能够预测跟随者可能的响应策略并提前采取对自己最有利的策略。