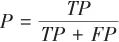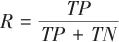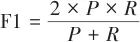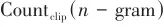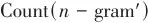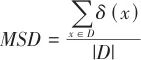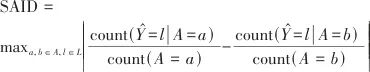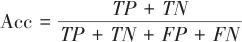
3.5 算法指标体系

机器算法是大模型的基石,也是大模型评估体系中的最小颗粒度,对算法评估应包括但不限于下列指标:
(1)准确率:预测正确的样本数占总样本数的比率。
图片 (10)
式中,TP为真正的正样例数量;TN为真正的负样例数量;FP为错误的正样例数量;FN为错误的负样例数量。准确率易受类别不平衡影响,当数据集不平衡时,准确率不再是可靠的度量指标。
(2)精度:预测类别为正样本集合中真实类别为正样本的比率。
图片 (11)
(3)召回率:被正确预测的正样本占全部正样本的比率。
图片 (12)
(4)错误率:对于给定的数据集,预测错误的样本占总样本的比率,即1-Acc。
(5)F1值:精度和召回率的调和平均数,衡量二分类模型精度的一种指标,兼顾了分类模型的精度和召回率。
图片 (13)
(6)KL散度:两个概率分布间的差异的非对称性度量,它比较了真实分布和理论(拟合)分布之间的差异[22]。
(7)ROC曲线:受试者工作特性曲线,由不同设定条件下的真正率和假正率值画出的响应曲线,是反映敏感性和特异性连续变量的综合指标。
(8)PRC曲线:精度召回率曲线,是一种同时显示不同阈值下深度学习算法精度和召回率的图形化方法。一般x轴表示召回率,y轴表示精度。
(9)CRC曲线:累积响应曲线,也称为增益曲线或增益图,是显示跨多个阈值的总数据中真阳性率和阳性预测百分比的图形方法。
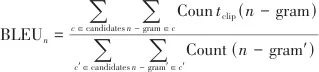
(10)BLEU(Bilingual Evaluation Under study)指标:其意思为双语评估替补,是一种用于机器翻译任务的评价指标,其总体思想为准确率[23]。如给定标准译文reference,神经网络生成的句子是candidate,句子长度为n,candidate中有m个单词出现在reference,m/n就是BLEU的1-gram的计算公式。根据n-gram可以划分成多种评价指标,常见的指标有BLEU-1、BLEU-2、BLEU-3、BLEU-4四种,其中n-gram指的是连续的单词个数为n。BLEU-1衡量的是单词级别的准确性,更高阶的BLEU可以衡量句子的流畅性[24]。高阶BLEU计算式如下:
图片 (14)
式中,图片表示某一个n-gram在reference中的个数;图片表示在candidate中的个数。

3.6 基础支撑服务

军事大模型的开发运行需要强大的软硬件基础环境,开展存储、计算和数据结构化处理与决策[25]。因此,大模型除了对训练芯片的计算性能有一定的要求外,还对硬件的规格,如显存大小、访存带宽和通信带宽具有较高的要求[26]。为实现大模型的高效训练和推理,需要通过深度学习框架实现与硬件的适配和深度协同优化,通过低成本、高效率的硬件适配方案[27]。大模型基础支撑服务评估,至少包含但不限于以下层次指标:
(1)存储。存储能力应包括:
1)存储管理:数据存储系统的整体管理能力,包括支持的存储容量、数据条目数量等,应支持向量数据库;
2)多样性:支持多种类型数据、多种开发语言的能力,应支持多种存储协议,如 NFS、SMB、FTP、HDFS、S3、POSIX 等,各协议均应保持原生协议相同的语义兼容性;
3)分布式可拓展:支持分布式架构的集群系统业务负载感知、降低运维复杂度的能力,应实现数据副本或纠删码冗余策略,实现租户级 QoS、Quota、用户认证域、业务网段等隔离;
4)其他:存储服务效率、设备故障预警和报警能力、存储数据恢复能力、接口便捷性和服务可用性等方面,应能承载动态混合负载,读写带宽宜不小于 1 TB;32 kB 小文件随机读取 IO 宜不低于 1 千万 IOPS/PB。
(2)计算。计算能力应包括:
1)数据计算:支持超大规模分布式计算、批量计算、流式计算、图计算、机器学习计算和边缘计算等复杂计算任务的能力。用于训练任务的计算设备算力理论值求和,百亿模型宜不低于 50PFLOPS(FP16 精度),千亿、万亿模型宜不低于 1000PFLOPS(FP16 精度)。用于对实时性要求高的推理任务的计算设备,平均 Token 输出时延宜不超过 100 ms。用于对实时性要求低的推理任务的计算设备,平均 Token 输出时延宜不超过 300 ms。推理任务下,百亿模型单卡总吞吐宜不低于 5 Tokens/s;
2)集群效率:简单高效地提供大规模集群的部署、调度、扩展和管理服务的能力;
3)稳定性:分布式架构部署的稳定性,包括保证故障自动恢复、快速迁移、连续运行时长等能力;
4)容错性:应具备在训练过程中有节点或网络连接出现故障(如节点、交换或路由设备不工作或性能下降)时,保证原有任务的继续进行,直到完成;
5)灵活性:根据业务变化和负载情况灵活调整的能力,以及是否能够提供便捷易用的自动化工具,支持多种框架、控制台、应用程序编程接口和软件开发包的能力,支持应用在云侧、边侧或端侧的 AI 计算设备上的运行;
6)统计监控:数据流、数据收发状态的统计监控、报警触发的能力。
(3)数据结构化处理与决策。数据结构化处理与决策业务服务能力应包括:
1)稳定性:数据处理模型对抗噪声和数据攻击的能力;
2)可用性:系统与用户的互协作能力;提供精确的数据分析结果,并给出可用决策建议的能力;在维护和调整时的在线实时服务能力等;
3)时效性:提供实时性和变化感知的能力;
4)透明性:数据处理和决策过程中模型的可解释性与流程的透明性;
5)泛化性:跨领域、覆盖多个场景的迁移能力和可扩展度,宜支持联邦学习,宜支持云内、云边或云端协同推理。
(4)机器学习。应能管理机器学习算法的运行环境配置,包括支持云侧设备、边缘设备和终端设备,机器学习支撑能力应包括:
1)全生存周期:支撑包含数据框架(采集、筛选、预标注、标注和脱敏等)、特征探索、模型开发(训练、评估和预测)、模型部署、模型管理、应用发布等全生存周期过程的能力;
2)训练性能:支撑具备高性能的运算能力;
3)兼容性:兼容其他训练模型代码的能力,包括主流的应用程序接口(API)和训练模型代码等;
4)灵活性:灵活分配计算资源的能力,包括训练时灵活分配计算资源的时间颗粒度、灵活的计量计费机制等;
5)易用性:操控人工智能服务所使用工具支持可视化的拖拽布局编程服务,组合各种数据源、组件、算法、模型和评估模块的能力;
6)算法库:支持提供插件式算子注入,支持多类算子及算法、时空分析、频繁项挖掘等能力。

3.7 综合安全防护

军事垂直领域的特殊使命决定了对大模型安全的更高要求,需要经过充分检验、具备高可信度和鲁棒性、与军队价值观对齐的安全对齐大模型。这些模型的设计和训练过程严格遵循军事伦理准则,具备透明度、可解释性和可审计性,使用户能够理解其行为和决策过程。同时,安全对齐大模型也需注重隐私和安全,确保在使用过程中不会泄露军事敏感信息或被恶意攻击[28]。其评估内容主要包括。
(1)安全与隐私。安全与隐私保护能力评估应包括:协议使用可信通道、确保用户的输入不能被第三方窃听的能力;数据存储中关于用户个人隐私的相关数据采用匿名脱敏存储、考虑算法安全机制,能够避免通过统计数据反推算法逻辑的能力;对敏感数据进行加密存储的能力;对不同用途和环境的设备进行必要的网络隔离、对不同安全级别的运算环境之间的互通进行权限检查的能力;对数据和服务调用进行鉴权的能力;对各种操作行为进行审计的能力;支撑数据恢复与备份的能力[29]。安全性的评估应包括下列内容:
1)攻击成功率:描述在经过攻击方法构建的新测试数据集中,模型预测失败的样本数与总样本数之间的比率。该指标量化了在外部攻击下模型的安全性,值越小表明模型在面对攻击时具有较高的抵抗能力,从而为模型的抵御攻击能力提供了度量。具体计算式如下:
图片 (15)
式中,图片表示攻击成功率;图片表示样本总数;图片表示预测失败的样本数。
2)模型窃取程度:描述通过如模型蒸馏或其他方法构建的代理模型与原始模型之间的性能差异。该指标量化了代理模型对原始模型的近似程度,值越大表明模型能够更好地近似或复制原始的模型功能,从而为模型的安全性或难以被复制的程度提供了度量。具体计算式如下:
图片 (16)
式中,图片表示模型窃取程度;图片表示数据集的样本总数;图片为指示函数,当代理模型的预测与原始模型的预测相同时为1,否则为0。
3)平均攻击查询次数:用来衡量生成对抗样本所需的平均模型查询次数。在这种情况下,攻击者试图通过在输入样本中引入微小的扰动来欺骗模型,使其产生错误的预测或分类结果。较少的查询次数意味着模型更容易受到攻击。
4)攻击隐蔽性:是指对抗攻击生成的对抗样本与原始样本之间的平均相似程度[30]。在攻击隐蔽性方面,攻击者的目标是生成的对抗样本尽可能与原始样本保持相似,以使人类观察者难以察觉到其存在。攻击隐蔽性越高,意味着对抗攻击可以更有效地欺骗模型[31]。
(2)公平性。公平性,即有无偏见性评估,主要评估大语言模型生成的内容是否会对某些社会群体产生不利影响或伤害。大语言模型可能会对某些群体持有刻板印象,或产生输出贬低特定群体的信息等偏见行为[32]。大语言模型中的偏见性可以直接从模型生成的文本中进行评估。大模型学习算法的公平性用于评估算法对于不同群体的处理是否有歧视和输出质量的差异。公平性的评估应包括下列内容:
1)敏感属性独立程度:衡量算法对不同敏感属性群体进行特定预测的比例之间的最大差异。这一指标旨在衡量在算法预测中,受保护属性的可能影响程度。理想情况下,一个公平的算法应该使得对于所有受保护属性群体的预测分布尽可能相同,即敏感属性对算法预测的影响很小。敏感属性独立程度数值较低表明模型预测对不同群体更加一致,体现了较高的公平性[33]。具体计算式如下:
图片 (17)
式中,图片表示敏感属性独立程度;图片表示敏感属性集合;L表示标签集合;图片表示模型的预测结果;图片表示计数函数。
2)模型决策分离程度:衡量在真实类别为特定值时,模型在不同敏感属性群体之间做出错误预测的概率的差异。该指标关注模型在特定真实类别下的错误决策,并比较这些错误在不同敏感属性群体之间的分布是否均衡。具体计算式如下:
图片 (18)
式中,图片表示模型决策分离程度;图片表示真实值,图片。
3)模型决策充分程度:衡量在模型预测标签为特定值时,模型在不同敏感属性群体之间正确预测该标签的概率的差异。该指标关注在模型预测为特定类别时的正确决策,并比较这些正确预测在不同敏感属性群体之间的分布是否均衡。具体计算式如下:
图片 (19)
式中,图片表示模型决策充分程度。

4 结 论图片

本文在分析梳理现有评估方法手段在军事垂直领域大模型评估现状不足的基础上,通过研究大模型赋能作战效能和装备体系的机理,围绕军事大模型评估开展了研究。从军事需求牵引和技术推动发展的角度分析了军事大模型评估的必要性和紧迫性;构建了一种正向分解逻辑与逆向聚合评估结合的评估体系框架;设计了评估流程,并采用定性定量相结合提出了相应评估指标体系,为军事大模型的评估探索了一套闭合逻辑链路、完整体系框架和具体衡量指标。为军事大模型的训练、微调、部署提供了评估依据,为军事大模型发挥效能、产生效益提供了基本参考依据,可作为军事大模型建设发展过程中先评后建和边评边用的方法流程,为军事大模型高质量高效益低成本建设发展提供了有益参考。


发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注